

 三里屯信息流
《鹖冠子》里有个故事:扁鹊是名医,却说两位哥哥的医术都在自己之上——大哥在病还没显露时就解决了,二哥在病刚露出苗头时就治好了,所以名气反倒都不如他。
优化师也是同理:提前解决问题,不一定有人看见;出了事再救回来,反而容易被当成“天神下凡”:
成本飙了,能想办法压回来;
消耗掉了,能赶紧补计划、补素材;
客户骂娘了,能马上安抚住。
可如果每天都在各种救火,这样的救火队长,到底算能力强,还是工作方式本身出了问题?
今年618,我们整个6月,账户并非完全没有波动,但团队基本没有被拖进连续救火的状态。
大促能做到这份儿上,含金量懂的都懂。
我们是怎么做到的呢?
那得从5月中开始说。
01 提前布局:别把确定会来的风险,当成突发事件
大盘怎么波动、平台规则怎么调、竞品会不会突然加预算,都不由优化师控制;但预算怎么拆、素材有没有储备、账户结构合不合理,肯定是可以提前准备的。
618这种节点尤其如此。如果等到6月流量竞争压力陡增,账户已经开始掉量,再临时扩账户、找素材,调整空间其实已经不大了。
所以从5月中旬开始,我们就和客户提前沟通了消耗策略,把一部分消耗前置到5月,分担6月的业绩压力。
当然,错峰最终还是要服从项目的KPI。如果客户考核的就是固定节点效果,或者预算不能跨周期调配,这套方法就不成立。
5月底,我们又根据当时的消耗和效果,重新拆了6月的分日预算,把更多预算安排在了月初;账户侧扩充了大约三分之一的备用账户,预先搭好一批基础计划;素材侧也提前准备了适配大促环境的差异化素材,而不是等原素材明显衰退后再临时补量。
最终,在一部分消耗按计划前置到5月的情况下,6月消耗量级比5月下降约10%,成本比5月下降约7%,整体符合此前和客户对齐的目标。小波动还是有,但没有演变成连续几天的临时灭火。
不是预测所有风险,而是别把那些明明知道会来的风险,等到最后一刻再当突发事件来处理。
真出问题时,手里有牌可打,和临时从零想办法完全是两种状态。
02 承接增量:冲规模,不是所有计划一起提价
突然扩量也一样。
上个月,客户原有日消耗约7万元,临时要求冲规模,希望迅速提升到15万元。我让团队先要回答一个问题:
新增的8万元,到底由谁来承接?
最简单的回答是,所有计划一起加预算、提价。为什么这种动作最容易成为第一反应?因为它最快,按钮一点、数字一改,马上就有动静。至于是不是好结果,是后面的事。
但不同版位、人群、素材和账户,表现本来就不一样。不看各自的承接能力,就一刀切地加预算、提价,看着是在冲规模,其实省掉了优化师最该做的判断。
所以我没有直接全量提价,而是重新拆历史数据,看哪些方向过去更稳定、ROI更好、还有继续承接增量的空间。新增预算优先给这些方向。原本承担稳定消耗的账户,尽量维持原有体量。
预算拉起来以后再看真实表现:某个方向的成本明显超出目标,就先控制规模,再切换其他测试方向继续承接。
最后用了大约一周时间,我把日消耗提到了15万,投放成本在客户目标范围内,也没有发生需要紧急大面积调整计划的情况。
这里真正要判断的是“分散”还是“集中”:
账户波动大、单一计划风险高时,多账户、多计划可以分散风险;已经验证出稳定跑量方向、需要继续放大规模时,就不能为了“安全”把预算拆得过散。
扩量不是大锅饭,而是要找到新增消耗真正能落下去的地方。
03 建设机制:同一个坑,别交两遍学费
除了大促和扩量,还有一种更常见的累:每天拉报表、刷后台、找素材、查数据,隔一会儿再刷新一次账户。
这些事情单独看都不难,但重复次数一多,就会不断吃掉真正需要判断和思考的时间。报表自动化、命名规范、素材归档、SOP,有一个共同特点:
今天不做,账户不会马上出问题。
所以越忙的人,越容易一直把它们往后放。
重复检查,能交给工具的尽量交给工具。时报、日报可以用固定模板和自动化工具减少手工整理;成本、消耗、曝光、转化等关键指标,也可以根据项目正常波动范围设置异常提醒。工具先发现异常,优化师再判断问题到底在哪里。
反复出现的问题,尽量沉淀成规则。账户和计划统一命名,素材按风格、测试周期、跑量标签等维度归档,常见的控本、调量、起量动作形成基本检查顺序。同一个坑踩过一次,没必要下一次再从头摸索。
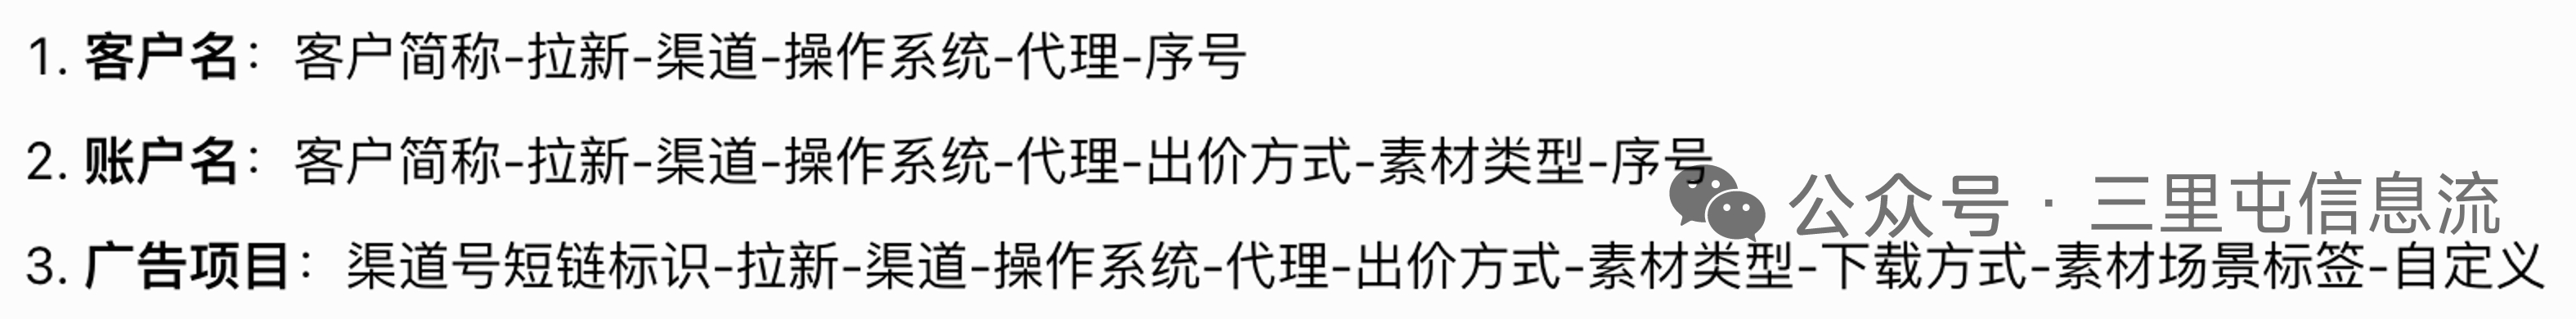
(命名规则 DEMO)
沟通也尽量固定节奏:哪些问题马上同步,哪些放到固定复盘,重要策略变化提前告诉哪些人,先把这些约定清楚。
救火处理的是今天的问题,机制建设决定的是明天还有没有同样的问题。
04 管理协作:很多账户问题,根本不发生在账户里
信息流投放从来不是优化师一个人的工作。素材决定前端能不能抓住用户,客户决定预算、目标和业务边界,优化师负责把这些条件转化成投放动作。
之前有一个新人带的美妆项目就很典型:
创意团队不断上新,但根本不清楚优化师到底想验证什么;客户看到短期波动,就马上临时改需求;优化师一边调账户,一边重新解释目标,经常被控本、卡量和各类临时确认打断。
这些“小事”叠加在一起,最后就变成了熊熊大火。
他跑过来跟我哭诉,我给他的建议只有一条:
改变协作方式。
素材侧,不再只说一句“这一批效果不好”,而是定期同步分素材、分风格的数据:哪些方向正在起量,哪些素材衰退更快,哪些值得继续测试。新素材单独建立测试记录,保障创新素材有独立测试空间;效果不及预期时,再继续拆画面、文案和转化链路,明确下一轮到底改什么。
客户侧,则把风险和策略尽量往前沟通:有潜在问题尽早说,调整出价、预算、定向时把判断逻辑一起讲明白,效果预期给合理区间,不做绝对承诺;临时需求来了,先判断它和当前核心目标是什么关系,再决定优先级。
从实际统计来看,这类临时控本、卡量和紧急协调,原来平均每周5次以上,调整协作方式以后降到了平均每周1次以内。
真正发生变化的,不是什么更厉害的调价技巧,而是素材、投放和客户开始围绕同一套信息做决策。
目标有没有对齐、关键数据有没有及时流动、策略变化有没有在执行前完成预期管理——这三件事如果没做好,很多所谓的“突发问题”其实早就有征兆。
很多账户问题,最后看起来发生在后台,其实早就在后台之外发生了。
05 为什么明明都懂,还是停不下来?
到这里,前面几个看起来不一样的问题,其实指向同一个原因:
救火的“正反馈”太快了。
成本高了,调下来。
账户掉量,拉回来。
客户催了,赶紧回。
马上调,马上有结果。
而很多前置工作恰好相反。整理素材库,当天不会直接让ROI变好;统一命名,不会马上多跑一笔消耗;提前和客户对齐风险,也很难马上看出到底避免了多少损失。
一个优化师越忙,越容易优先处理那些马上能看到结果的事情;而真正决定长期效率的工作,偏偏大多不会在今天奖励你。
于是前置工作再往后拖一天,下一次账户出问题,就又要重新救一次。
这也是为什么“很会救火”的人,有时候反而最容易长期困在救火里。
真正难的往往不是不知道该做什么,而是能不能把那些短期看不到成绩的事情,也当成投放工作本身。
当然,救火多不一定都是优化师个人的问题。团队有没有给前置建设留时间、项目考核是不是只盯当期结果、优化师有没有足够的预算和客户沟通空间,都会影响这些机制能不能真正建立起来。
06 最后
账户突然掉量时,能迅速找到办法,当然是能力。平台会变,流量会波动,素材会衰退,没有任何优化师能提前预测所有问题。
但有些问题已经不是第一次出现,有些坑也已经踩过很多遍。
真正的变化,可能发生在某一天:你发现自己没有以前那么忙了,同样的问题也已经很久没有再出现。
那时候反而没有什么“英雄时刻”。
就像故事里扁鹊的两位哥哥,问题刚刚是个“隐患”就被早早解决了,同事甚至不知道你做过什么。
但这可能才是你真正走向高效的开始。
下一次复盘,真正值得问的可能不只是:“这个月我救了多少次火?”
而是:“这些火里,有多少原本可以不烧起来?”